2.6 Unified Memory 与 System Memory
来源:《CUDA Programming Guide》13.4.2,书内第 118–128 页相关内容。正文为中文,常用 CUDA 与 memory 术语保留英文;代码保留原文,恢复 PDF 断行与缩进。
异构系统有多个物理 memory:host CPU 连接自己的 DRAM,每个 GPU 也有各自 DRAM。通常,让数据驻留在访问它的处理器直接连接的 memory 中,性能最好。
CUDA 提供显式控制放置的 API,但这可能使代码冗长、设计复杂。因此又提供多种机制,简化不同物理 memory 之间的分配、放置与迁移。
本节介绍这些机制对功能和性能的影响。Unified Memory 的形式取决于操作系统、driver、GPU 及互连,需要先识别系统属于哪种模式;更完整的介绍见 Unified Memory。
| 概念 | 含义 |
|---|---|
| Unified Virtual Address Space | CPU 和各 GPU 的 memory 地址在同一进程虚拟地址空间中具有各自可辨识的范围。 |
| Unified Memory | 允许 managed memory 由 CPU、GPU 访问,并按需迁移等。 |
| Limited Unified Memory | 具有部分功能限制的模式。 |
| Full Unified Memory | 完整支持 Unified Memory 功能。 |
| Hardware-coherent Full Unified Memory | 通过硬件实现一致性的完整支持。 |
| Unified Memory hint | 针对具体分配提供行为建议的 API。 |
| Page-locked Host Memory | 不可换出的 system memory,部分 CUDA 操作需要它。 |
| Mapped Memory | 让 kernel 直接访问 host memory 的机制,与 Unified Memory 不同。 |
| HMM | Linux 的 Heterogeneous Memory Management,可提供软件一致性的完整 Unified Memory。 |
| ATS | Address Translation Services;原文所述 NVLink Chip-to-Chip(C2C)系统利用它提供硬件一致性支持。 |
2.6.1 Unified Virtual Address Space
在同一个操作系统进程内,全部 host memory 与所有 GPU 的 global memory 采用统一虚拟地址空间。无论通过 CUDA API(如 cudaMalloc、cudaMallocHost)还是系统 API(如 new、malloc、mmap)分配,地址都位于这一空间中。CPU 和每个 GPU 的分配区域可以由地址区分。
因此:
- 可用
cudaPointerGetAttributes()根据指针查询其属性,判断所在位置。 cudaMemcpy*()的方向参数可使用cudaMemcpyDefault,由源、目标指针自动确定复制类型。
2.6.2 Unified Memory
Unified Memory 允许名为 managed memory 的分配,由 CPU 或 GPU 上的代码访问,前面的 C++ 示例 已展示基本用法。所有 CUDA 支持的系统都提供某种形式的 Unified Memory。
某些系统需要显式分配 managed memory,方法包括:
cudaMallocManaged。cudaMallocFromPoolAsync,且 pool 创建时将allocType设为cudaMemAllocationTypeManaged。- 使用
__managed__声明的全局变量,见 Memory Space Specifiers。
支持 HMM 或 ATS 的系统上,所有 system memory 都隐式具有 managed memory 能力,无需特殊 allocator。
2.6.2.1 Unified Memory 模式
行为随操作系统、Linux kernel、GPU、CPU/GPU 互连变化。可使用 cudaDeviceGetAttribute 查询:
| Device attribute | 含义 |
|---|---|
cudaDevAttrConcurrentManagedAccess | 1 表示完整支持;0 表示有限支持。 |
cudaDevAttrPageableMemoryAccess | 1 表示所有 system memory 都完整支持;0 表示只有显式 managed 分配具备相应支持。 |
cudaDevAttrPageableMemoryAccessUsesHostPageTables | 对所有 system memory 完整支持时,1 表示使用 host page table 的硬件机制,0 表示软件机制。 |
共有四类模式:显式 managed 分配的完整支持、所有分配的软件一致性完整支持、所有分配的硬件一致性完整支持,以及有限支持。Windows 与部分 Tegra 系统属于有限支持。
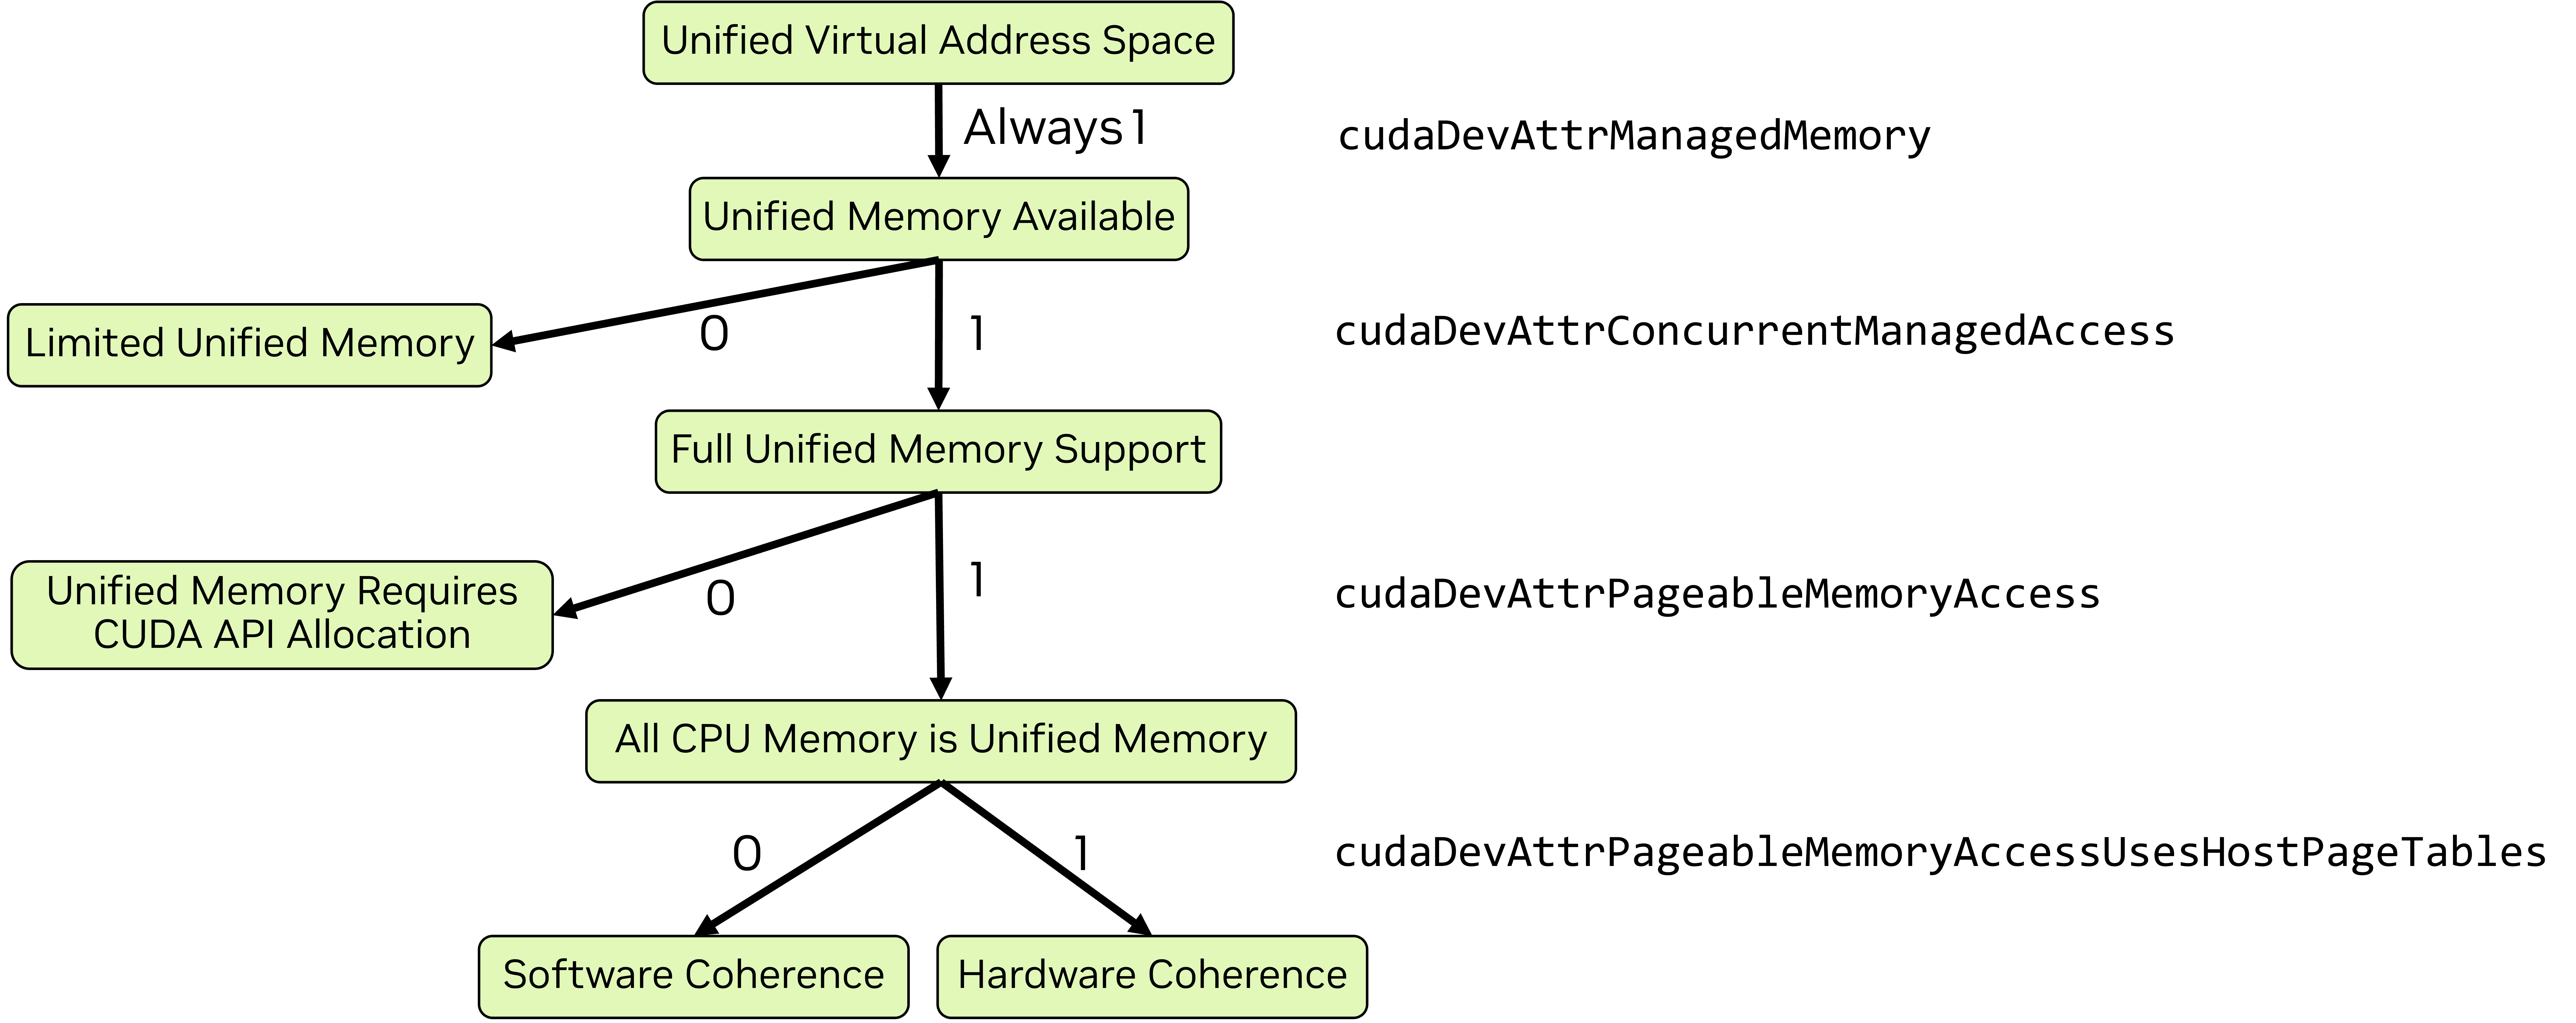
图 21:Unified Memory 模式判断流程。先检查 ConcurrentManagedAccess,再检查 PageableMemoryAccess,最后根据 PageableMemoryAccessUsesHostPageTables 区分硬件与软件一致性。所有本版支持的 GPU 使用统一虚拟地址空间,并提供相应的 Unified Memory 能力。
表 3:Unified Memory 模式概览。以下缩写分别对应上表三项属性。
| 模式 | 属性条件 | 详细说明 |
|---|---|---|
| 有限支持 | ConcurrentManagedAccess = 0 | Windows、WSL 与 Tegra 上的 Unified Memory;另见 CUDA for Tegra 文档。 |
| 显式 managed 分配的完整支持 | ConcurrentManagedAccess = 1,PageableMemoryAccess = 0 | 仅支持 CUDA Managed Memory 的设备 |
| 所有分配,软件一致性 | 上述前两项均为 1,PageableMemoryAccessUsesHostPageTables = 0 | 完整 Unified Memory 支持 |
| 所有分配,硬件一致性 | 三项均为 1 | 完整 Unified Memory 支持 |
2.6.2.1.1 Unified Memory 模式查询示例
下面按图 21 的逻辑查询系统中每个 GPU 的属性,并判断其 Unified Memory 模式。
void queryDevices()
{
    int numDevices = 0;
    cudaGetDeviceCount(&numDevices);
    for(int i=0; i<numDevices; i++)
    {
        cudaSetDevice(i);
        cudaInitDevice(0, 0, 0);
        int deviceId = i;
        int concurrentManagedAccess = -1;
        cudaDeviceGetAttribute (&concurrentManagedAccess, cudaDevAttrConcurrentManagedAccess, deviceId);
        int pageableMemoryAccess = -1;
        cudaDeviceGetAttribute (&pageableMemoryAccess, cudaDevAttrPageableMemoryAccess, deviceId);
        int pageableMemoryAccessUsesHostPageTables = -1;
        cudaDeviceGetAttribute (&pageableMemoryAccessUsesHostPageTables, cudaDevAttrPageableMemoryAccessUsesHostPageTables, deviceId);
        printf("Device %d has ", deviceId);
        if(concurrentManagedAccess){
            if(pageableMemoryAccess){
                printf("full unified memory support");
                if( pageableMemoryAccessUsesHostPageTables)
                    { printf(" with hardware coherency\n"); }
                else
                    { printf(" with software coherency\n"); }
            }
            else
                { printf("full unified memory support for CUDA-made managed allocations\n"); }
        }
        else
        { printf("limited unified memory support: Windows, WSL, or Tegra\n"); }
    }
}
2.6.2.2 完整 Unified Memory 支持
多数 Linux 系统具有完整支持。若 cudaDevAttrPageableMemoryAccess = 1,所有 system memory 都具备完整能力,包括 CUDA allocator、系统 allocator,以及 mmap 创建的 file-backed memory。
如果该属性为 0,只有 CUDA 显式 managed 分配采用 Unified Memory;普通系统分配不是 managed,GPU kernel 不一定能访问。
对完整支持的 managed 分配,通常有以下行为:
- 数据物理上通常在首次访问它的处理器一侧建立,即 first touch。
- 当另一处理器访问时,数据通常迁移到访问方。
- 软件一致性通常按 page 粒度迁移或访问,硬件一致性可按 cache line 粒度处理。
- 允许 oversubscription,即 managed 分配总量超过 GPU 物理 memory 容量。
具体放置、迁移可能偏离这些一般行为,程序员也可通过 hint 与 prefetch 影响它们。完整说明见 完整 Unified Memory 支持。
2.6.2.2.1 采用硬件一致性的完整支持
Grace Hopper、Grace Blackwell 等系统使用 NVIDIA CPU,并通过 NVLink C2C 连接 CPU、GPU,可提供 ATS。其 cudaDevAttrPageableMemoryAccessUsesHostPageTables 为 1。
除所有 host 分配具备完整 Unified Memory 支持外,还包括:
- CPU 可直接访问驻留 GPU 的 managed 分配而无需迁移,
cudaDevAttrDirectManagedMemAccessFromHost = 1。 - CPU/GPU 链路支持 native atomic,
cudaDevAttrHostNativeAtomicSupported = 1。 - 硬件一致性可以比软件一致性提供更高性能。
ATS 覆盖 HMM 的能力;ATS 可用时,HMM 自动禁用。两者区别见 CPU/GPU page table:硬件与软件一致性。
注意
硬件一致性不会让 host 自动获得对 cudaMalloc 等 GPU-only 分配的访问能力。
2.6.2.2.2 HMM:采用软件一致性的完整支持
Heterogeneous Memory Management 是适当 Linux kernel 版本支持的功能,为 PCIe 连接的 GPU 提供软件一致性的完整 Unified Memory,带来部分与 ATS 类似的便利性。
原文列出 Linux kernel 6.1.24、6.2.11、6.3 或更新版本作为可能提供 HMM 的版本条件。可运行下面的命令查看 addressing mode 是否为 HMM:
$ nvidia-smi -q | grep Addressing
Addressing Mode : HMM
HMM 可用时,所有系统分配都隐式属于 Unified Memory。若系统同时有 ATS,则使用功能更完整的 ATS,并禁用 HMM。
2.6.2.3 有限 Unified Memory 支持
Windows(包括 WSL)及部分 Tegra 系统提供受限子集。Managed memory 可用,但 CPU/GPU 迁移方式不同:
- 初始物理分配位于 CPU memory。
- 迁移粒度可能大于虚拟 memory page。
- GPU 开始执行时迁移到 GPU。
- GPU 活跃期间 CPU 不得访问 managed memory。
- 与 GPU 同步后,相关数据返回 CPU 可访问状态,原文将此概括为迁移回 CPU。
- 不允许 GPU memory oversubscription。
- 只有通过 CUDA 显式 managed 分配的 memory 才具备该能力。
详细条件见 Windows、WSL 与 Tegra 上的 Unified Memory。
2.6.2.4 Memory Advise 与 Prefetch
cudaMemAdvise 可向 driver 描述分配属性,影响数据放置,以及从其他 device 访问时是否迁移。
cudaMemPrefetchAsync 可建议提前异步迁移特定区域。常见用法是在 kernel launch 前预取它将使用的数据,让传输与其他 GPU kernel 重叠。
不同 hint 和 prefetch 示例见 性能提示。
2.6.3 Page-Locked Host Memory
前面的 cudaMallocHost 在 host 分配 page-locked memory,也称 pinned memory。相比之下,malloc、new、mmap 的普通分配通常不是 page-locked,操作系统可能将它们换出或移动物理位置。
Page-locked host memory 用于 CPU/GPU 异步复制,也有助于同步复制性能;还可映射给 GPU,使 kernel 直接访问。
| API | 作用 |
|---|---|
cudaMallocHost | 分配 page-locked host memory。 |
cudaHostAlloc | 默认类似 cudaMallocHost,额外接受 flags。 |
cudaFreeHost | 释放以上两个 API 的分配。 |
cudaHostRegister | 将 malloc、mmap 等创建的既有区域注册并页锁定。 |
cudaHostRegister 使第三方库或其他不可控代码分配的 memory 也能用于异步复制或映射。
注意
Page-locked host memory 可供系统中的各 GPU 用于相关复制与映射。在非 I/O-coherent Tegra device 上,它不被 cache,而且 cudaHostRegister() 不受支持。
2.6.3.1 Mapped Memory
有 HMM 或 ATS 时,GPU 可直接使用 host 指针访问 host memory。二者都没有时,可通过映射将 host 分配暴露到 GPU 地址空间。Mapped memory 必须保持 page-locked。
下面的数组复制 kernel 直接读写 mapped host memory。
__global__ void copyKernel(float* a, float* b)
{
        int idx = threadIdx.x + blockDim.x * blockIdx.x;
        a[idx] = b[idx];
}
这种方法适合部分不希望提前复制到 GPU 的数据,但访问必须经过 PCIe 或 NVLink C2C 等 CPU/GPU 互连,延迟更高、带宽更低。对 kernel 的主要数据,不应将 mapped memory 视为 Unified Memory 或显式 device memory 管理的高性能替代。
2.6.3.1.1 cudaMallocHost 与 cudaHostAlloc
cudaMallocHost、cudaHostAlloc 分配的 host memory 自动具备相应映射能力,可以在原文所述系统上直接将返回指针传入 kernel,通过互连访问 host memory。
cudaMallocHost 示例:
void usingMallocHost() {
  float* a = nullptr;
  float* b = nullptr;
  CUDA_CHECK(cudaMallocHost(&a, vLen*sizeof(float)));
  CUDA_CHECK(cudaMallocHost(&b, vLen*sizeof(float)));
  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));
  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(a, b);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());
  printf("Using cudaMallocHost: ");
  checkAnswer(a,b);
}
cudaHostAlloc 示例:
void usingCudaHostAlloc() {
  float* a = nullptr;
  float* b = nullptr;
  CUDA_CHECK(cudaHostAlloc(&a, vLen*sizeof(float), cudaHostAllocMapped));
  CUDA_CHECK(cudaHostAlloc(&b, vLen*sizeof(float), cudaHostAllocMapped));
  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));
  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(a, b);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());
  printf("Using cudaHostAlloc: ");
  checkAnswer(a, b);
}
2.6.3.1.2 cudaHostRegister
没有 HMM、ATS 时,系统 allocator 分配的 memory 仍可通过 cudaHostRegister 注册并映射。但与上述 CUDA allocator 不同,原文要求使用 cudaHostGetDevicePointer() 获取 device 可用指针,kernel 使用该指针访问。
void usingRegister() {
  float* a = nullptr;
  float* b = nullptr;
  float* devA = nullptr;
  float* devB = nullptr;
  a = (float*)malloc(vLen*sizeof(float));
  b = (float*)malloc(vLen*sizeof(float));
  CUDA_CHECK(cudaHostRegister(a, vLen*sizeof(float), 0 ));
  CUDA_CHECK(cudaHostRegister(b, vLen*sizeof(float), 0 ));
  CUDA_CHECK(cudaHostGetDevicePointer((void**)&devA, (void*)a, 0));
  CUDA_CHECK(cudaHostGetDevicePointer((void**)&devB, (void*)b, 0));
  initVector(b, vLen);
  memset(a, 0, vLen*sizeof(float));
  int threads = 256;
  int blocks = vLen/threads;
  copyKernel<<<blocks, threads>>>(devA, devB);
  CUDA_CHECK(cudaGetLastError());
  CUDA_CHECK(cudaDeviceSynchronize());
  printf("Using cudaHostRegister: ");
  checkAnswer(a, b);
}
2.6.3.1.3 Unified Memory 与 Mapped Memory 的比较
Mapped memory 让 GPU 能访问 CPU memory,但并不保证所有系统都支持全部访问类型,例如 atomic。Unified Memory 按其支持模式提供相应的访问语义。
Mapped memory 保留在 CPU 一侧,GPU 的每次访问都必须经过互连,通常无法充分利用 GPU memory 带宽。Unified Memory 通常将数据迁移到访问处理器一侧,首次迁移后,对相同 page 或 cache line 的反复访问可利用 GPU 本地带宽。
注意
旧文档也将 mapped memory 称为 zero-copy memory。
早期没有统一虚拟地址空间时,需要 cudaSetDeviceFlags 配合 cudaDeviceMapHost 等额外启用步骤;原文所述当前模式已不再需要这些旧步骤。
对 mapped host memory 使用的 CUDA atomic,从 host 或其他 GPU 的视角看,不一定具有同样的原子性,参见 Atomic Functions。
CUDA runtime 要求 device 发起的自然对齐 1、2、4、8、16 字节 host memory load/store,从 host 和其他 device 的角度看保持为单次访问。部分硬件可能将 atomic 拆成 load 与 store,但拆分后的操作仍需满足自然对齐访问要求。Runtime 不支持会拆分自然对齐 8 字节访问的 PCIe bridge 拓扑;原文还说明 NVIDIA 未发现拆分自然对齐 16 字节访问的拓扑。
2.6.4 小结
- 支持 HMM 或 ATS 的 Linux 平台,系统 allocator 分配的 memory 也具备 managed memory 能力。
- 无 HMM、ATS 的 Linux,以及原文所述 Tegra、Windows 平台,需要通过 CUDA 显式 managed 分配:
cudaMallocManaged、使用cudaMemAllocationTypeManagedpool 的cudaMallocFromPoolAsync,或__managed__全局变量。 - Windows 与部分 Tegra 的 Unified Memory 存在功能限制。
- NVLink C2C 与 ATS 系统上,驻留 GPU 的
cudaMallocManaged分配可以按其支持能力由 CPU 或其他 GPU 直接访问。