1.3 CUDA 平台
NVIDIA CUDA 平台由许多软硬件组件构成,并包含为异构系统计算而开发的多项重要技术。本节介绍其中一些应用程序开发者需要理解的基本概念和组件。与第 1.2 节编程模型一样,本节不针对特定编程语言,而适用于所有使用 CUDA 平台的程序。
1.3.1 Compute Capability 与 SM 版本
每个 NVIDIA GPU 都有一个Compute Capability(计算能力,CC)编号,表明该 GPU 支持哪些功能,并规定其部分硬件参数。这些规格记录在第 5.1 节 Compute Capabilities中。NVIDIA 的 CUDA GPU Compute Capability 页面维护了所有 NVIDIA GPU 及其 Compute Capability 的列表。
Compute Capability 采用 X.Y 的格式,由主版本号和次版本号组成,其中 X 是主版本号,Y 是次版本号。例如,CC 12.0 的主版本号是 12,次版本号是 0。Compute Capability 与 SM 的版本号直接对应。例如,CC 12.0 GPU 内的 SM 版本为 sm_120。这个版本用于标记二进制文件。
第 5.1.1 节 Obtain the GPU Compute Capability介绍了如何查询并确定系统中 GPU 的 Compute Capability。
1.3.2 CUDA Toolkit 与 NVIDIA 驱动程序
可以将 NVIDIA 驱动程序理解为 GPU 的操作系统。它是必须安装在 host 操作系统上的软件组件,任何 GPU 用途都需要它,包括显示和图形功能。NVIDIA 驱动程序是 CUDA 平台的基础。除了 CUDA,它还提供 Vulkan、Direct3D 等其他使用 GPU 的方式。NVIDIA 驱动程序使用诸如 r580 这样的版本号。
CUDA Toolkit 是用于编写、构建和分析 GPU 计算软件的一组库、头文件及工具。CUDA Toolkit 与 NVIDIA 驱动程序是两个独立的软件产品。
CUDA runtime(CUDA 运行时)是 CUDA Toolkit 所提供库中的一个特殊组件。它提供 API 和一些语言扩展,用于处理常见任务,例如分配内存、在 GPU 与其他 GPU 或 CPU 之间复制数据,以及启动 kernel。CUDA runtime 的 API 部分称为 CUDA Runtime API。
CUDA Compatibility 文档详细说明了不同 GPU、NVIDIA 驱动程序与 CUDA Toolkit 版本之间的兼容性。
1.3.2.1 CUDA Runtime API 与 CUDA Driver API
CUDA Runtime API 建立在更底层的 CUDA Driver API 之上,后者是由 NVIDIA 驱动程序公开的 API。本指南主要介绍 CUDA Runtime API 提供的接口。如果需要,只使用 Driver API 也能实现相同的功能;有些功能仅通过 Driver API 提供。应用程序可以使用任意一种 API,也可以将两者互操作地结合使用。第 3.3 节 The CUDA Driver API介绍了两者之间的互操作。
CUDA Runtime API 各函数的完整参考,参见 CUDA Runtime API Documentation。
CUDA Driver API 各函数的完整参考,参见 CUDA Driver API Documentation。
1.3.3 PTX
CUDA 平台中一个基础但有时对开发者不可见的层,是PTX(Parallel Thread Execution,并行线程执行)虚拟指令集架构(ISA)。PTX 是面向 NVIDIA GPU 的高级汇编语言,在真实 GPU 硬件的物理指令集之上提供抽象层。与其他平台类似,也可以直接使用这种汇编语言编写应用程序,但这可能给软件开发增加不必要的复杂度和难度。
领域专用语言及高级语言编译器可以生成 PTX 代码,将其作为中间表示(Intermediate Representation,IR),然后使用 NVIDIA 的离线或即时(Just-in-Time,JIT)编译工具,生成可执行的 GPU 二进制代码。这样,除了 NVIDIA 工具(例如第 2.7 节 NVCC: The NVIDIA CUDA Compiler所介绍的 NVCC)直接支持的语言外,其他语言也能用于 CUDA 平台编程。
由于 GPU 能力会随着时间变化和增强,PTX 虚拟 ISA 规范也具有版本。PTX 版本与 SM 版本类似,对应于某个 Compute Capability。例如,支持 Compute Capability 8.0 全部功能的 PTX 被称为 compute_80。
PTX 的完整文档参见 PTX ISA。
1.3.4 Cubin 与 Fatbin
CUDA 应用程序和库通常使用 C++ 等较高级语言编写。这些语言先编译为 PTX,然后 PTX 再被编译为针对物理 GPU 的实际二进制代码,称为 CUDA binary,简称 cubin。Cubin 使用特定的二进制格式,面向某个具体的 SM 版本,例如 sm_120。
使用 GPU 计算的可执行文件和库二进制文件,同时包含 CPU 与 GPU 代码。GPU 代码存放在一个称为 fatbin 的容器中。Fatbin 可以包含面向多个不同目标的 cubin 和 PTX。例如,一个应用程序可以同时构建面向多种 GPU 架构,即不同 SM 版本的二进制代码。应用程序运行时,其 GPU 代码会被加载到某个具体的 GPU 上,并使用 fatbin 中最适合该 GPU 的二进制版本。
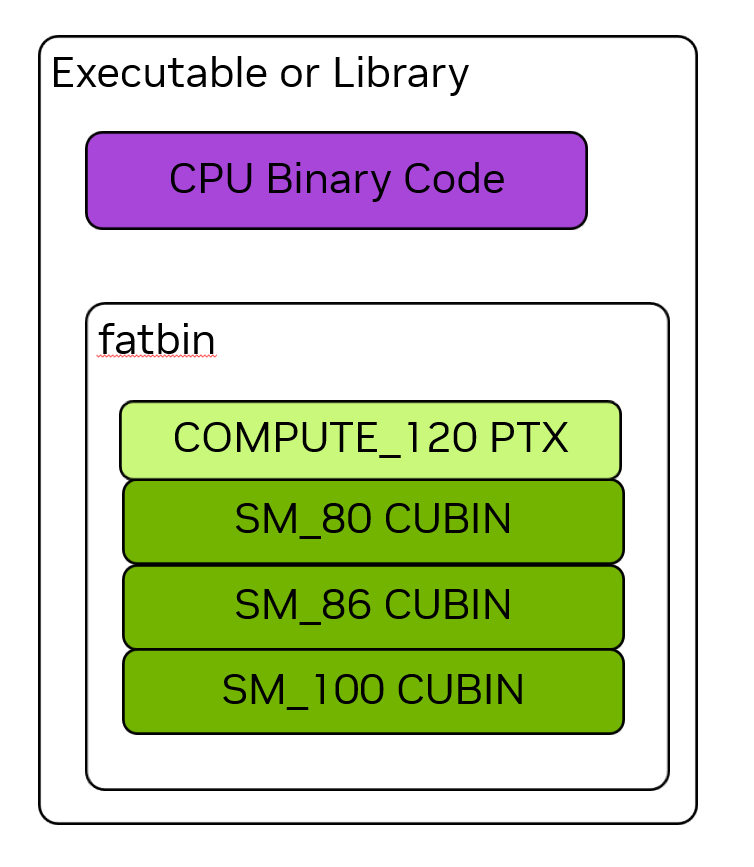
图 10:可执行文件或库的二进制文件,同时包含 CPU 二进制代码,以及用于 GPU 代码的 fatbin 容器。Fatbin 可以同时包含 cubin 格式的 GPU 二进制代码和 PTX 虚拟 ISA 代码。PTX 代码可通过 JIT 编译,支持未来的目标架构。
Fatbin 还可以包含一个或多个 PTX 版本的 GPU 代码,其用途见第 1.3.4.2 节 PTX 兼容性。图 10 展示了一个应用程序或库二进制文件,其中包含多个 cubin 版本的 GPU 代码,以及一个 PTX 版本的代码。
1.3.4.1 二进制兼容性
NVIDIA GPU 在某些条件下保证二进制兼容。具体来说,在 Compute Capability 主版本号相同的情况下,如果 GPU 的 Compute Capability 次版本号大于或等于 cubin 的目标次版本号,那么该 GPU 就能加载并执行该 cubin。例如,如果一个应用程序包含针对 Compute Capability 8.6 编译的 cubin,那么它可以在 Compute Capability 为 8.6 或 8.9 的 GPU 上加载和执行。但它不能在 Compute Capability 为 8.0 的 GPU 上加载,因为 GPU 的 CC 次版本号 0 低于代码的次版本号 6。
不同 Compute Capability 主版本之间不具备二进制兼容性。也就是说,针对 Compute Capability 8.6 编译的 cubin,不能在 Compute Capability 为 9.0 的 GPU 上加载。
讨论二进制代码时,通常会使用类似上述示例中的 sm_86 来表示代码版本。这相当于说,该二进制代码是面向 Compute Capability 8.6 构建的。开发者向 NVIDIA CUDA 编译器 nvcc 指定二进制构建目标时,就使用这种写法,因此经常采用这一简称。
注意:二进制兼容性保证仅适用于由
nvcc等 NVIDIA 工具生成的二进制文件。不支持手工修改或自行生成 NVIDIA GPU 二进制代码。如果以任何方式修改二进制文件,兼容性保证即失效。
1.3.4.2 PTX 兼容性
GPU 代码可以以二进制或 PTX 形式存储在可执行文件中,参见第 1.3.4 节 Cubin 与 Fatbin。如果应用程序保存了 GPU 代码的 PTX 版本,那么运行时就可以针对 Compute Capability 等于或高于该 PTX 目标 Compute Capability 的 GPU,对其进行 JIT 编译。例如,如果应用程序包含面向 compute_80 的 PTX,那么运行时就可以将其 JIT 编译为面向 sm_120 等后续 SM 版本的代码。这使应用程序和库无需重新构建,也能向前兼容未来的 GPU。
1.3.4.3 JIT 编译
应用程序在运行时加载的 PTX 代码,由设备驱动程序编译为二进制代码。这称为JIT 编译(即时编译)。JIT 编译会增加应用程序加载时间,但能使应用程序受益于新设备驱动程序所包含的编译器改进。它还允许应用程序运行在其编译时尚不存在的设备上。
设备驱动程序为应用程序 JIT 编译 PTX 时,会自动缓存一份生成的二进制代码,避免后续启动应用程序时重复编译。该 cache 称为compute cache(计算缓存)。设备驱动程序升级时,compute cache 会自动失效,使应用程序能够受益于新驱动程序内置 JIT 编译器的改进。
与 CUDA 的早期版本相比,运行时何时以及如何对 PTX 进行 JIT 编译的限制已经放宽,开发者可以更加灵活地决定是否对部分或全部 kernel 执行 JIT,以及何时执行。第 4.8 节 Lazy Loading(延迟加载)介绍了可用选项,以及如何控制 JIT 行为。此外,还有一些环境变量可以控制 JIT 编译行为,详见第 5.2 节 CUDA Environment Variables。
除了使用 nvcc 编译 CUDA C++ device code,还可以使用 NVRTC 在运行时将 CUDA C++ device code 编译为 PTX。NVRTC 是 CUDA C++ 的运行时编译库,更多信息参见 NVRTC User Guide。
1.3.4.4 binary finalization
从 Compute Capability 10.0 开始,同一 GPU 家族内部的二进制兼容性由 NVIDIA 驱动程序通过软件管理。面向 CC 10.0 及后续架构的 cubin 采用扩展二进制表示的格式,以提供家族内部的二进制兼容性。
针对特定目标架构生成,即完成finalization(二进制定型)的二进制代码,可以直接在该目标架构上执行,也可以在运行时重新 finalization,以适配任何具有二进制兼容性保证的 GPU。Compute Capability 为 9.x 及更早版本的 cubin,不支持运行时重新 finalization。
如果一个面向 CC 10.0 或更高版本的 cubin,是为某个目标架构生成的,但被加载到同一 GPU 家族中另一个兼容架构上,那么驱动程序会进行即时 finalization,将 cubin 绑定到目标 GPU 的架构。该过程称为off-target finalization(非原目标定型)。
off-target finalization 支持off-target execution(非原目标执行):为一个架构完成 finalization 的 cubin,可以在同一 GPU 家族内另一个兼容架构上运行。如果 cubin 加载到它最初生成时针对的架构上,则属于on-target execution(原目标执行),无需进一步 finalization。
面向 off-target execution 的即时 finalization,与 PTX JIT 编译是不同的过程。PTX JIT 编译将 PTX 代码编译为 GPU 二进制代码,并且已经针对目标架构完成 finalization;cubin 的 off-target finalization,则是将现有 cubin 重新 finalization 到另一个兼容架构。off-target finalization 的开销显著低于 PTX JIT 编译,但与 on-target execution 相比,仍可能增加模块加载时间。
off-target finalization 的开销取决于需要进行 finalization 的代码量、模块加载期间可用的 host CPU 资源,以及源架构和目标架构之间的关系。如果应用程序加载大型模块或大量模块,在 cubin 需要进行 off-target finalization 时,可能会观察到启动时间增加。
与 PTX JIT 编译一样,NVIDIA 驱动程序也可能缓存 cubin off-target finalization 的结果,以避免在应用程序后续运行时重复执行 finalization 工作。该 cache 由第 5.2.2 节 JIT Compilation所述的同一组 CUDA cache 环境变量控制。