1.1 引言
1.1.1 图形处理器
图形处理器(Graphics Processing Unit,GPU)最初是面向三维图形的专用处理器,采用固定功能硬件,加速实时三维渲染中的并行操作。随着一代代产品的发展,GPU 的可编程能力不断增强。到 2003 年,图形流水线中的部分阶段已经能够完全编程,可以针对三维场景或图像中的各个组成部分并行运行自定义代码。
2006 年,NVIDIA 推出了计算统一设备架构(Compute Unified Device Architecture,CUDA),使任何计算工作负载都能独立于图形 API,利用 GPU 的高吞吐能力。
此后,CUDA 和 GPU 计算被用于加速几乎所有类型的计算任务,从流体动力学、能量传输等科学仿真,到数据库、数据分析等商业应用。此外,GPU 的计算能力和可编程性也为新算法与新技术的发展奠定了基础,涵盖图像分类,以及扩散模型、大语言模型等生成式人工智能。
1.1.2 使用 GPU 的优势
在相近的价格和功耗范围内,GPU 能提供远高于 CPU 的指令吞吐量和 memory bandwidth。许多应用利用这些能力,在 GPU 上获得了明显快于 CPU 的运行速度(参见原书中的 GPU Applications 链接)。FPGA 等其他计算设备同样具有很高的能效,但其编程灵活性远低于 GPU。
GPU 与 CPU 的设计目标不同。CPU 致力于尽可能快地执行一串串行操作,即一个 thread(线程),并能并行执行几十个这样的 thread。GPU 则致力于同时执行数千个 thread,通过牺牲部分单个 thread 的性能,获得高得多的总体吞吐量。
GPU 专门面向高度并行的计算,因此将更多晶体管用于数据处理单元;CPU 则将更多晶体管用于数据 cache 和流程控制。图 1 展示了 CPU 与 GPU 芯片资源分配的一个示例。
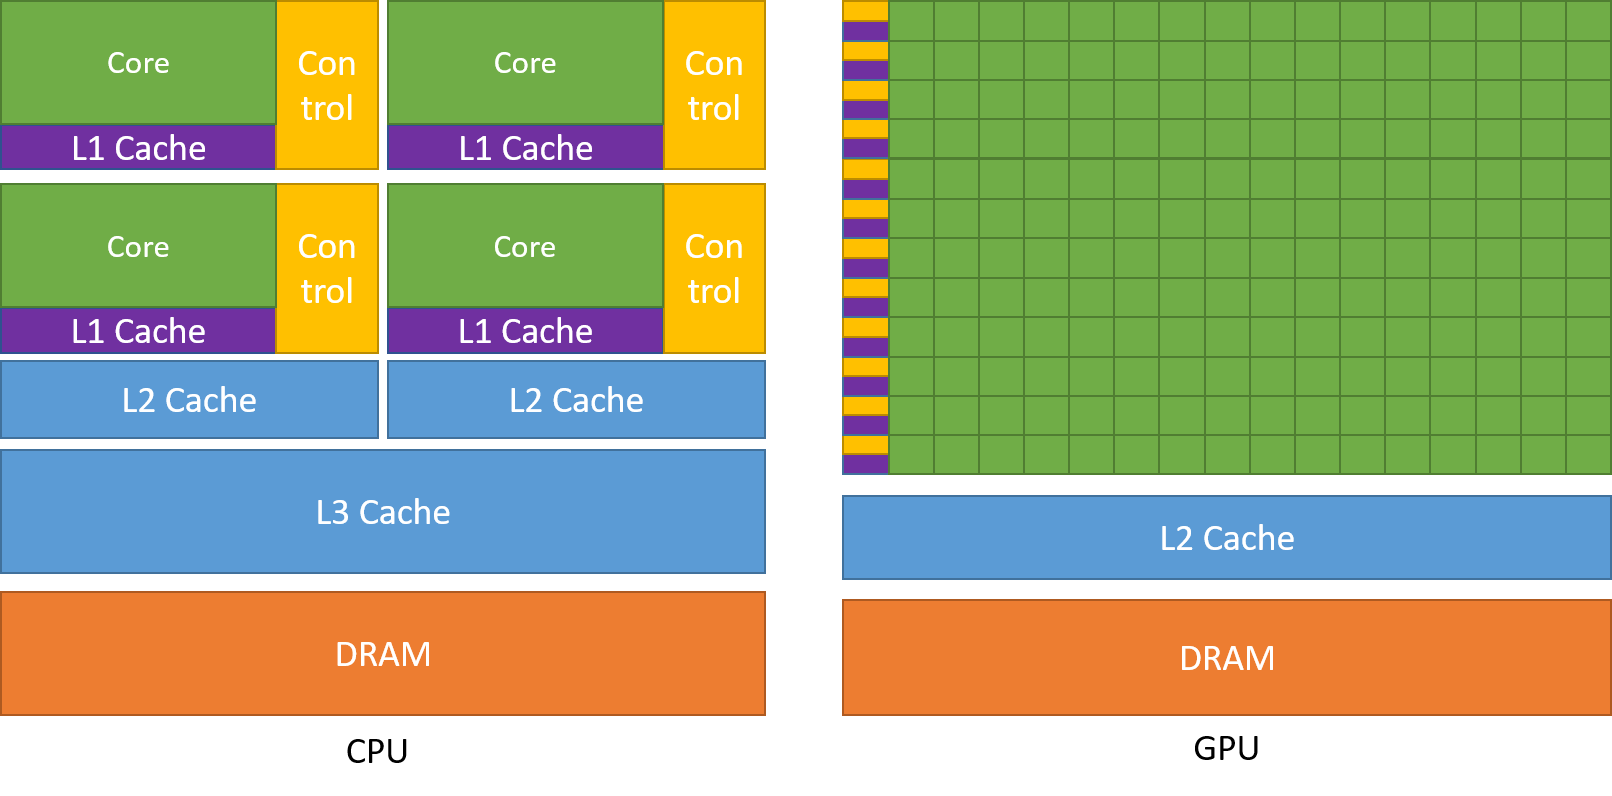
图 1:GPU 将更多晶体管用于数据处理。
1.1.3 快速入门
利用 GPU 的计算能力有很多途径。本指南介绍如何使用 C++ 等高级语言为 CUDA GPU 平台编程。不过,应用程序也有许多无需直接编写 GPU 代码就能使用 GPU 的方法。
各个领域中越来越多的算法和例程,都可以通过专用库获得。如果某个库已经实现了所需功能,尤其是 NVIDIA 提供的库,那么使用它通常比从头重新实现算法具有更高的开发效率和更好的性能。cuBLAS、cuFFT、cuDNN 和 CUTLASS 只是其中几个例子,它们帮助开发者避免重复实现成熟算法。这些库还针对不同 GPU 架构进行了优化,能够兼顾开发效率、性能和可移植性。
此外,一些框架,特别是人工智能领域使用的框架,也提供了 GPU 加速的基础组件。许多框架正是通过调用上述 GPU 加速库来实现加速。
NVIDIA 的 Warp、OpenAI 的 Triton 等领域专用语言(Domain-Specific Language,DSL),也可以编译为直接在 CUDA 平台上运行的代码。与本指南介绍的高级语言相比,它们提供了抽象层次更高的 GPU 编程方式。
NVIDIA Accelerated Computing Hub 提供了用于学习 GPU 和 CUDA 计算的资源、示例及教程。