CUDA 入门(一):硬件认识与第一个 CUDA 程序
引言:学习资料与运行环境
刚开始学习 CUDA 时,我遇到的第一个问题是:代码里的 thread、block 和 grid,与 GPU 里面的硬件到底是什么关系?如果只记住一个计算下标的公式,很容易把程序跑起来,却说不清数据交给了谁、计算在哪里发生,以及 CPU 什么时候才能拿到结果。
这篇笔记先从硬件和工作组织方式讲起,再用一个数组相加的例子,把显存分配、数据传输、kernel 启动、结果验证和计时串起来。读者只需要有基本编程经验,文中用到的 CUDA 特有语法会随代码解释。
本文主要参考 NVIDIA 官方的 CUDA Programming Guide,尤其是编程模型和 CUDA C++ 入门部分。硬件示意图也直接引用官方文档,并在图片下标明来源。计时部分补充参考 CUDA Best Practices Guide。
本地没有 NVIDIA GPU,也可以先用 LeetGPU Playground 在浏览器中编写和运行示例。进入编辑器后选择 CUDA,粘贴完整程序,再运行即可。在线环境的执行方式和可用资源可能变化,做性能实验前,需要记录它实际报告的设备和运行模式。
本文的第一个目标是把程序算对,并理解执行过程;后面的计时示例用于建立测量方法,不预设某个 GPU 型号或性能数字。
本文的完整程序、边界与随机测试、两种计时示例已整理到仓库的 CUDA 向量加法目录,每份源码都可以独立运行。
一、GPU 硬件结构
1.1 CPU 与 GPU 的分工
CUDA 程序通常从 CPU 上的 main() 开始执行。CPU 负责准备数据、申请资源、提交 GPU 任务以及处理结果;适合并行处理的计算则交给 GPU。
CUDA 文档中经常出现两组名称:
| 名称 | 本文中的含义 |
|---|---|
| host,主机 | CPU 一侧 |
| host memory,主机内存 | CPU 使用的内存 |
| device,设备 | GPU 一侧 |
| device memory,设备内存 | GPU 使用的内存,本文主要指 GPU 显存 |
下面采用常见的独立显卡模型:CPU 内存与 GPU 显存分别分配,程序显式搬运输入和输出。统一内存等其他方式可以在掌握这个流程后再学习。
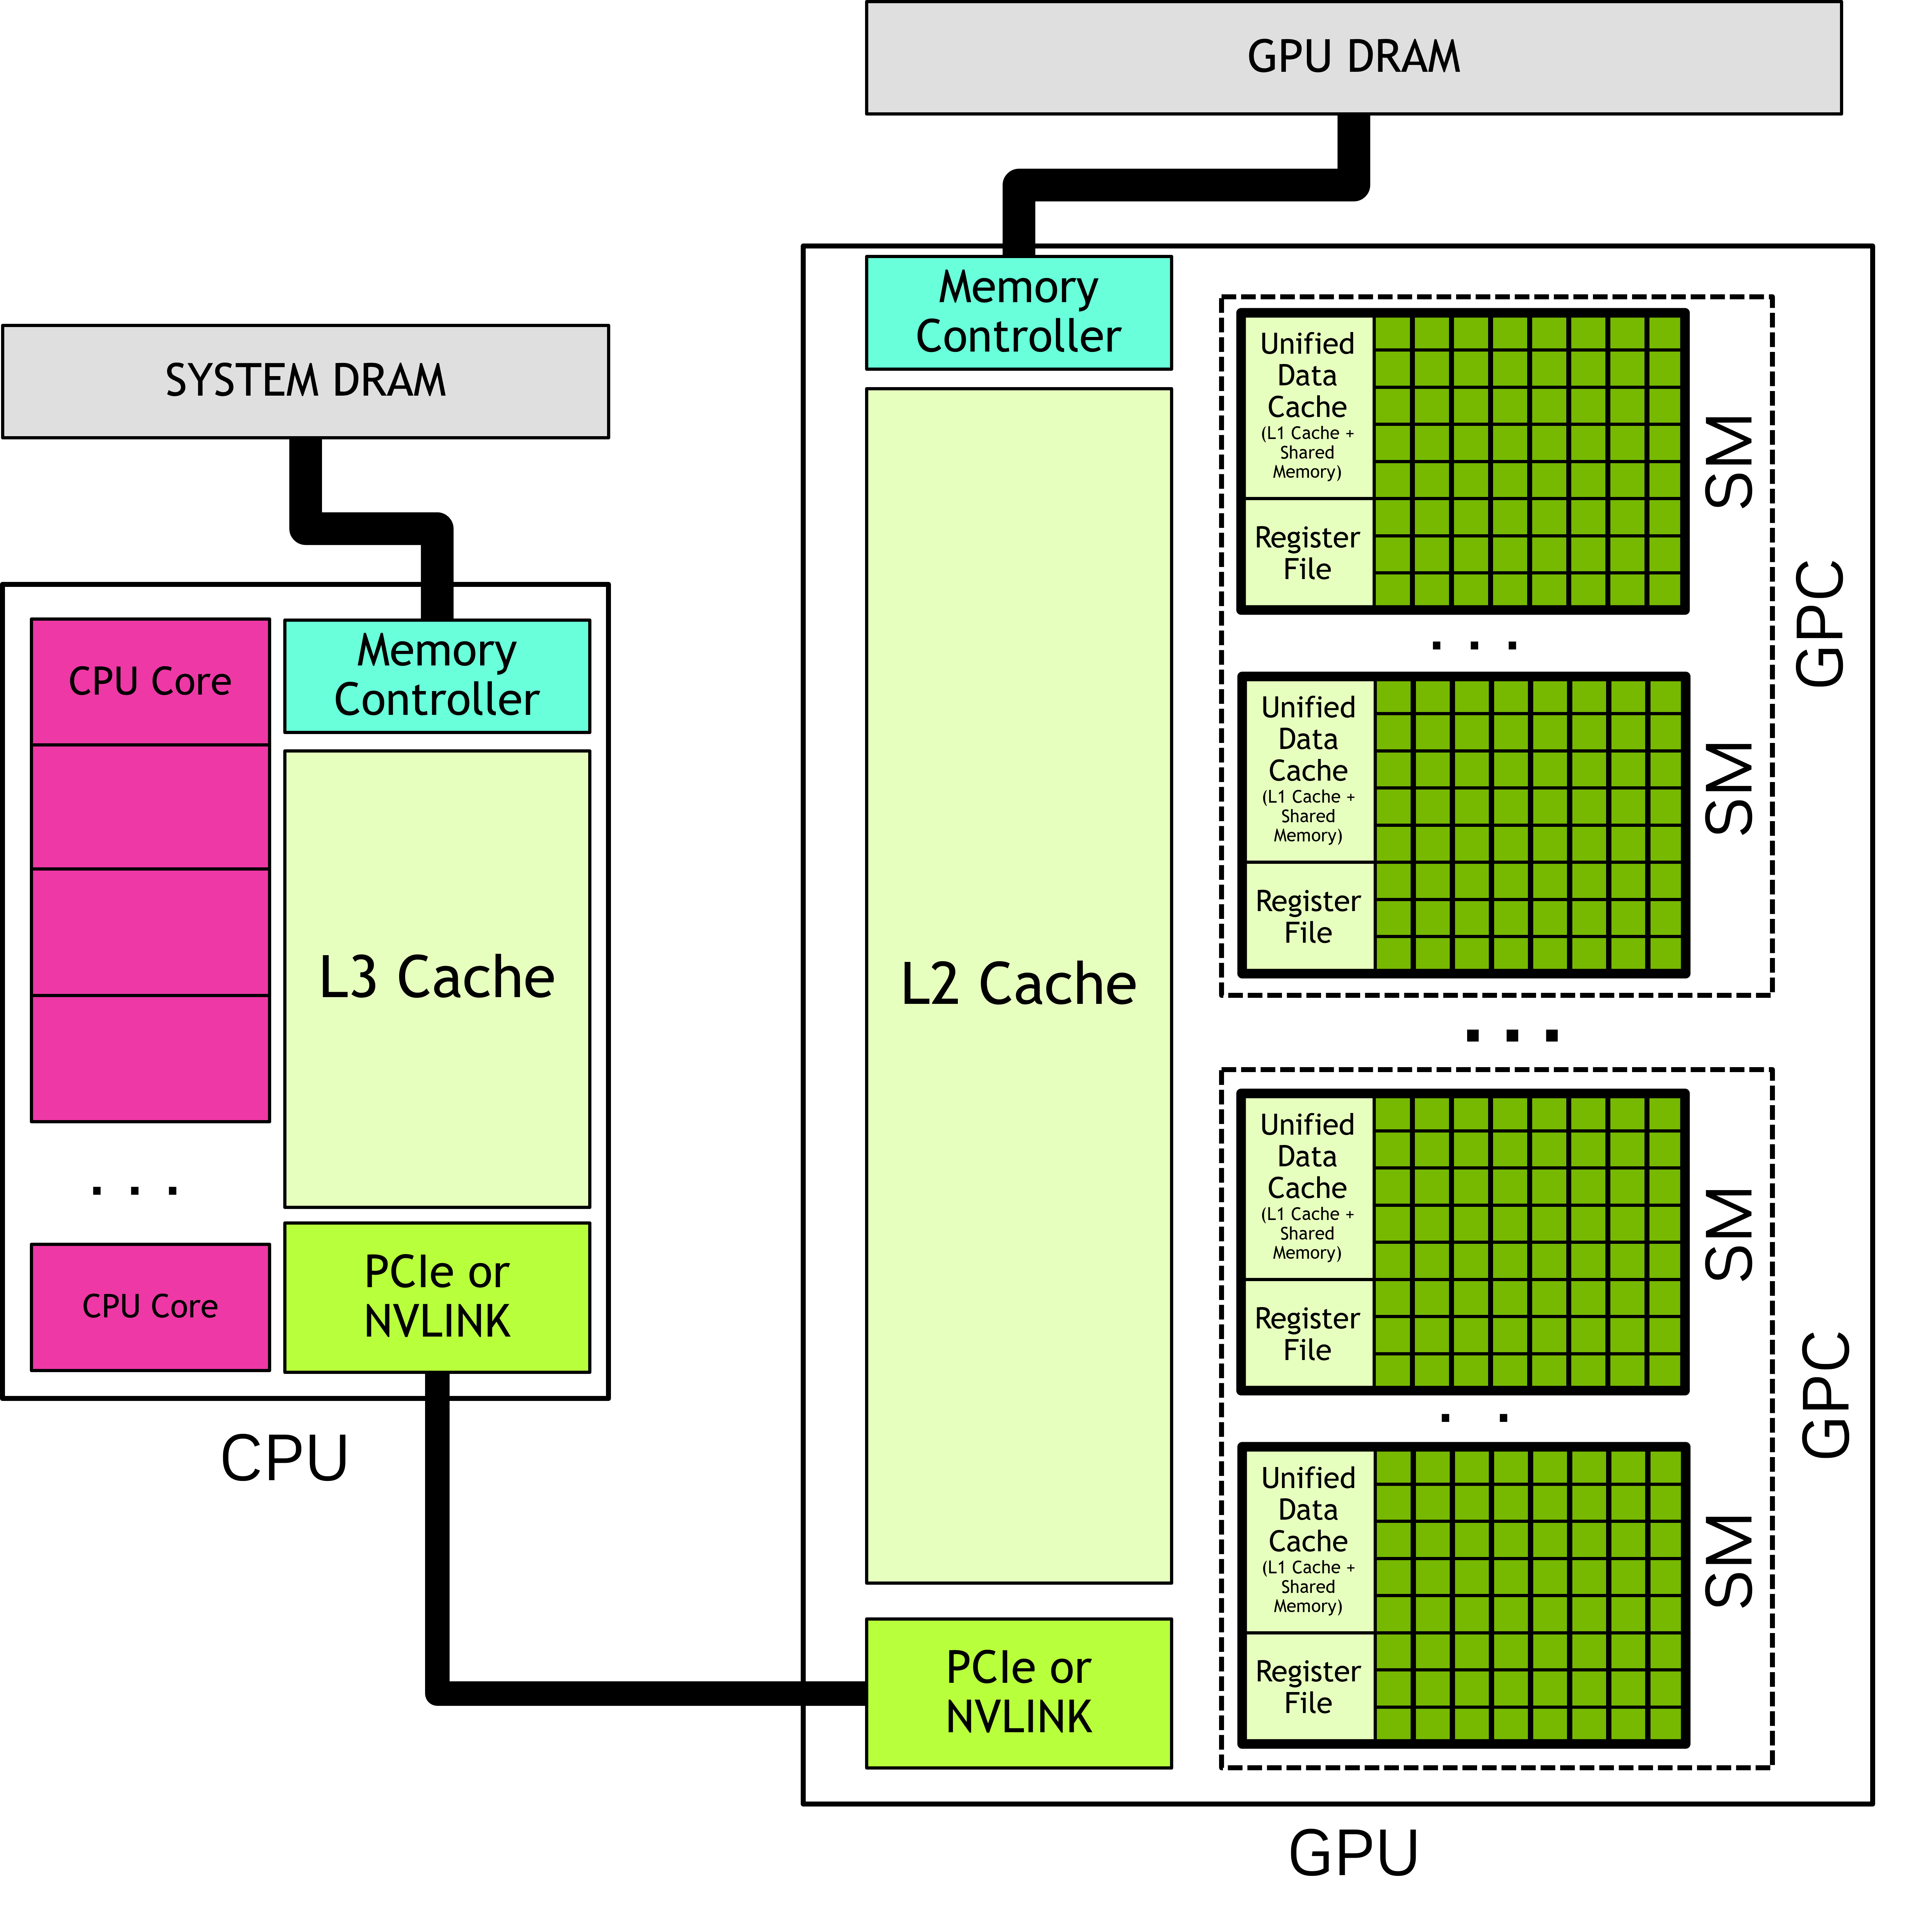
图 1:CPU、GPU 及其存储与互连关系。来源:CUDA Programming Guide,GPU Hardware Model。图表示组成关系,具体数量和配置因 GPU 架构而异。
读这张图时,可以先找到 CPU 和 GPU 两侧,再看各自连接的内存。CPU 与 GPU 之间通过 PCIe、NVLink 等互连交换数据。后面代码中的内存拷贝,就是在这个系统中搬运数据。
1.2 SM 的组成与职责
GPU 包含多个 SM(Streaming Multiprocessor,流式多处理器)。SM 内部有执行计算、调度工作和存储临时数据的硬件资源。若干 SM 还会组成图中的 GPC;目前先知道这个上层分组存在即可。
对于入门,先认识下面几类 SM 内部资源:
| 组成 | 基本用途 |
|---|---|
| 调度器 | 选择就绪的线程束,安排指令执行 |
| 算术执行单元 | 执行浮点、整数等运算 |
| Load/store 单元 | 执行读取和写入操作 |
| 寄存器文件 | 保存线程的寄存器状态和临时数据 |
| Shared memory / L1 | 提供靠近执行单元的片上存储资源 |
规格表里的 CUDA Core 可以先理解为 SM 中的一类算术执行资源。SM、CUDA Core、程序中的 thread 是不同层次的概念。 一个 CUDA thread 也不会在整个运行过程中永久占有一个专属 CUDA Core。
1.3 GPU 的存储层次
GPU 的计算单元需要从存储系统取得数据,才能完成运算。先建立一张位置与用途的对照表:
| 存储资源 | 基本位置 | 本文需要理解的作用 |
|---|---|---|
| 显存 / global memory | GPU 连接的 DRAM | 存放输入、输出等较大的数组 |
| L2 cache | GPU 内部 | 为多个 SM 的数据访问提供缓存 |
| L1 cache | SM 内部 | 为本 SM 的数据访问提供缓存 |
| Shared memory | SM 内部 | 由程序显式使用,常用于 block 内协作和数据复用 |
| 寄存器 | SM 内部 | 保存线程使用的操作数、索引等临时状态 |
在现代 NVIDIA GPU 的硬件模型中,L1 和 shared memory 使用相关的片上存储资源,具体容量与分配方式依架构而异。这里先认识位置和用途,不需要记住各型号的容量。
后面的向量加法会把数组放在 global memory 中。线程临时使用的索引和操作数通常由编译器安排在寄存器中;是否命中缓存、具体使用哪些寄存器,要由实际执行和编译结果决定。
二、CUDA 的工作组织模型
2.1 Kernel 与并行执行
**Kernel(核函数)**是交给 GPU 执行的函数。CPU 启动一次 kernel 时,会指定一组线程,让这些线程执行同一份代码。
程序员通常描述的是“一个线程需要做什么”。每个线程再利用自己的编号,选择负责的数据。
这些线程按以下方式组织:
一次 kernel 启动对应一个 grid
└── grid 包含多个 block
    └── 每个 block 包含多个 thread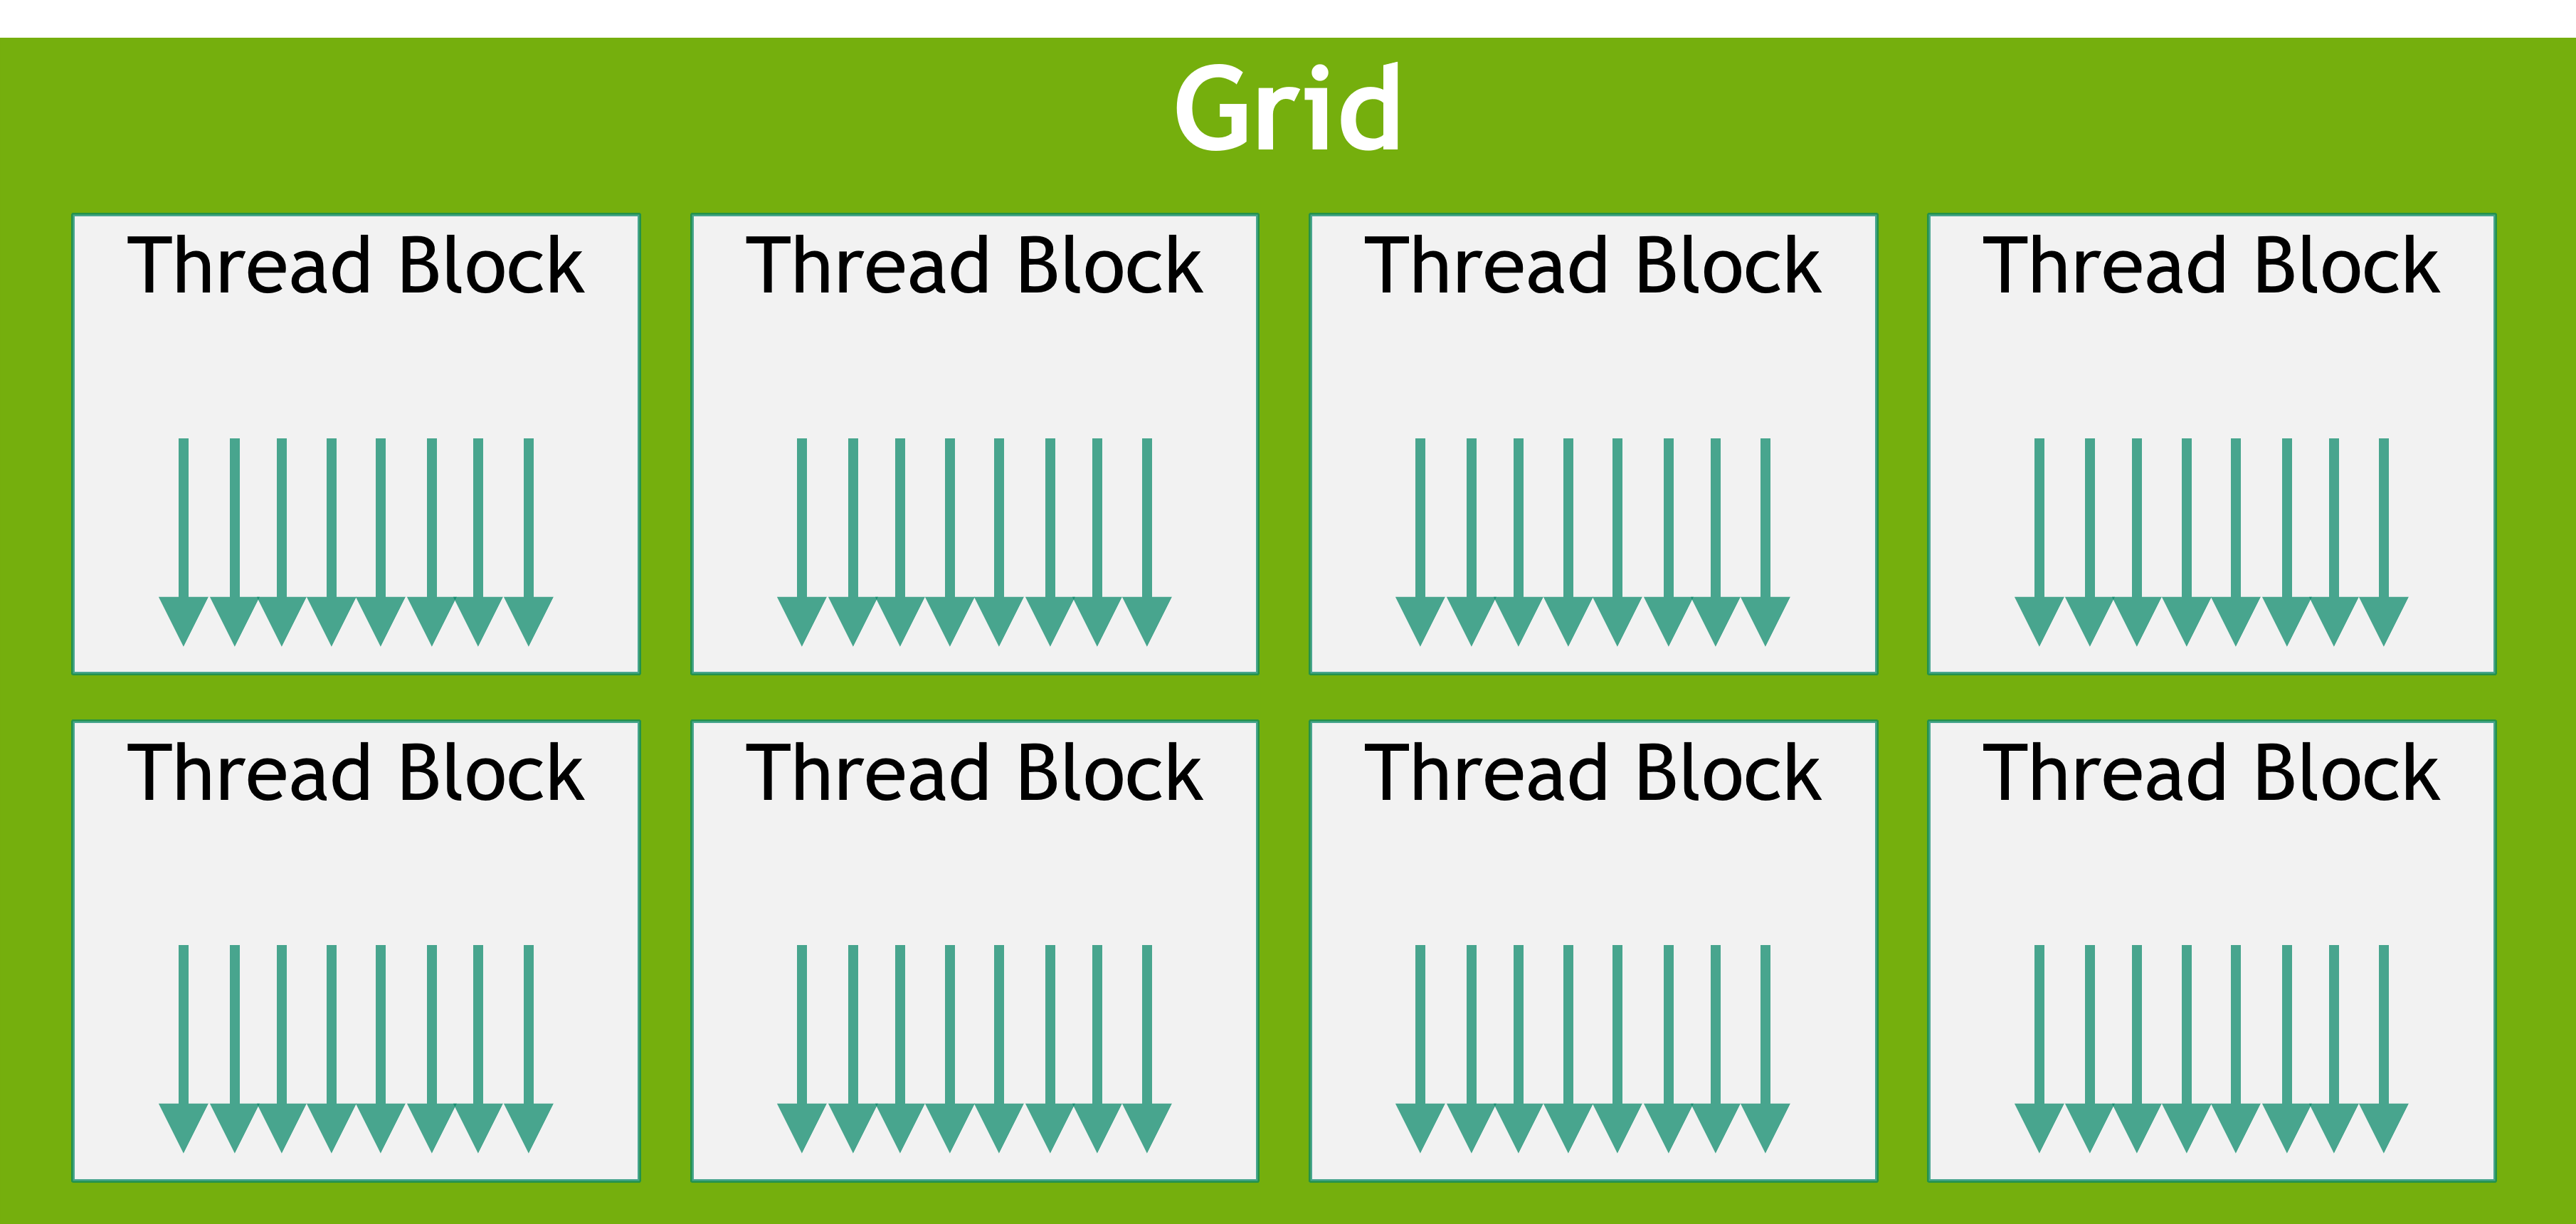
图 2:grid 由多个 block 组成,图中每个箭头表示一个线程,箭头数量不代表实际线程数。来源:CUDA Programming Guide,Thread Blocks and Grids。
Block 和 grid 都可以是一维、二维或三维。本文只使用一维,因此代码中的内置变量都取 .x 分量。
2.2 Block、warp 与 SM 的关系
Block 是程序指定的线程分组,SM 是执行这些工作的硬件。两者之间有几个重要关系:
- 一个 block 的线程在同一个 SM 上执行。
- 资源允许时,一个 SM 可以同时驻留多个 block。
- 尚未获得资源的 block 等待后续调度。
- 不同 block 的调度顺序没有保证。
因此,程序可以提交几千个 block,GPU 只有几十个 SM,硬件会逐步完成这些工作。Block 编号并不表示它固定属于哪个 SM,也不表示它一定比后面的 block 先执行。
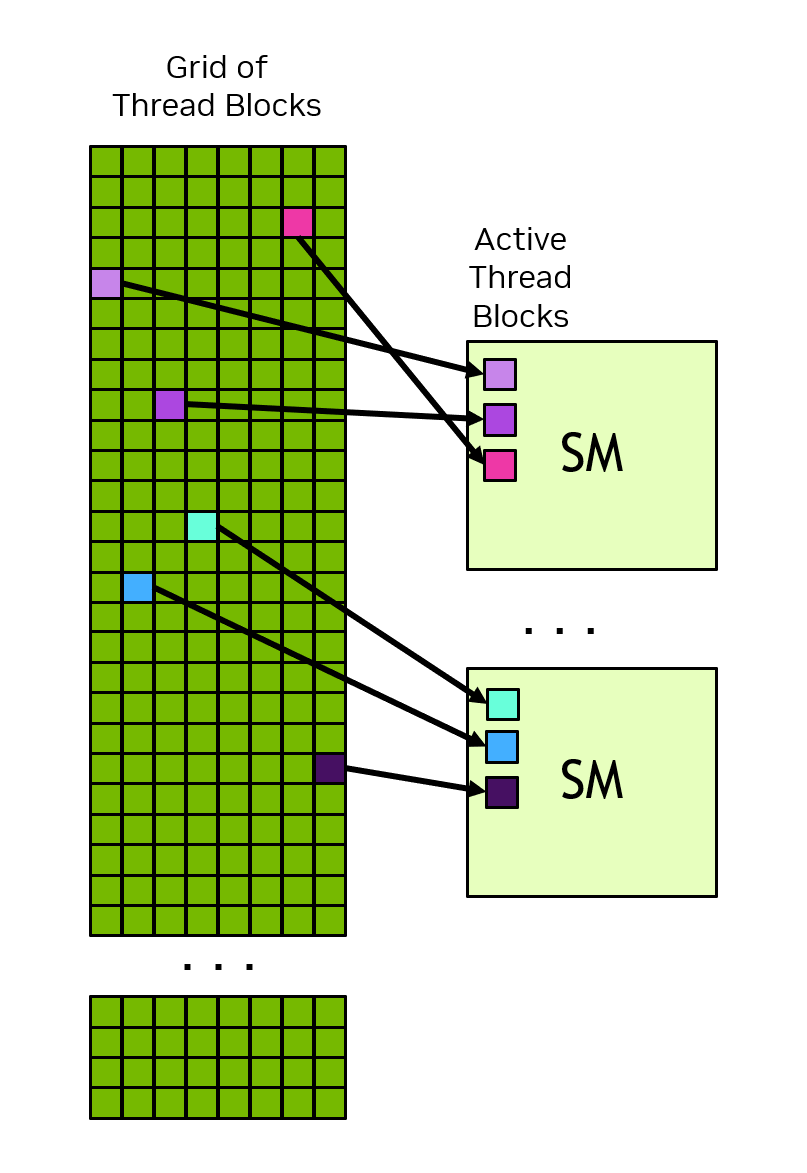
图 3:SM 可以驻留多个 block,硬件根据可用资源安排工作。来源:CUDA Programming Guide,Thread Block Scheduling。
在 block 内,线程进一步按每组 32 个组织成 warp(线程束)。在本文的一维 block 中,线程 0~31 属于第一个 warp,32~63 属于第二个 warp,依此类推。一个 256 线程的 block 包含 8 个 warp。
Warp 是理解 SM 调度和指令执行的重要单位。这里先记住分组关系;“驻留”表示工作及其状态已经占用 SM 资源,并不表示所有驻留线程在同一时刻都执行指令。
2.3 Kernel 的启动配置
CUDA C++ 使用三尖括号指定启动配置:
vector_add<<<blocks, threads>>>(a, b, c, n);在本文的一维配置中,blocks 是 grid 中的 block 数量,threads 是每个 block 的线程数量。例如:
vector_add<<<4, 256>>>(a, b, c, n);表示创建 4 个 block,每个 block 256 个线程,共 1024 个线程。这个数量描述了提交的工作,不承诺这 1024 个线程在同一时刻执行。
2.4 线程编号与数组下标
Kernel 内可以读取这些内置变量:
| 变量 | 一维配置中的含义 |
|---|---|
threadIdx.x | 线程在 block 内的编号,从 0 开始 |
blockIdx.x | block 在 grid 内的编号,从 0 开始 |
blockDim.x | 每个 block 的线程数 |
gridDim.x | grid 中的 block 数量 |
如果每个线程负责一个元素,那么 block 前面的所有线程占据了 blockIdx.x * blockDim.x 个位置。再加上块内线程编号,就得到数组下标:
int i = blockIdx.x * blockDim.x + threadIdx.x;例如,每块 256 个线程时,block 2 中的线程 7 对应:
i = 2 × 256 + 7 = 519这个线程就可以负责输出数组中的第 519 号元素。
三、向量加法 kernel 的实现
3.1 向量加法的线程分工
给定两个长度为 n 的数组,希望逐元素相加:
C[i] = A[i] + B[i],其中 0 <= i < nCPU 上可以用一个循环完成:
for (int i = 0; i < n; ++i) {
    c[i] = a[i] + b[i];
}
计算 c[519] 不需要 c[518] 的结果。假设输入与输出存储区互不重叠,各线程只写自己的输出元素,就可以独立完成计算。本文先采用最直观的方案:一个线程负责一个元素。
3.2 向量加法 kernel 代码
__global__ void vector_add(
    const float* a, const float* b, float* c, int n)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;

    if (i < n) {
        c[i] = a[i] + b[i];
    }
}
这里的 __global__ 声明一个 kernel。参数 a、b、c 要指向 GPU 可以访问的存储区,后面的完整程序会显式分配显存。const float* 表示 kernel 通过这个指针读取输入,不修改对应数据。
每个线程都会执行索引计算,再检查自己是否拥有一个有效元素。if (i < n) 用来阻止多余线程访问数组边界之外的位置。
3.3 Block 数量的向上取整
先选择每个 block 256 个线程。对于 n > 0 的普通尺寸,可以用整数运算向上取整:
int threads = 256;
int blocks = (n + threads - 1) / threads;例如,n = 1025 时需要 5 个 block,总共启动 1280 个线程:
| Block 编号 | 计算得到的下标范围 | 实际处理的元素 |
|---|---|---|
| 0 | 0~255 | 全部有效 |
| 1 | 256~511 | 全部有效 |
| 2 | 512~767 | 全部有效 |
| 3 | 768~1023 | 全部有效 |
| 4 | 1024~1279 | 只有下标 1024 有效 |
最后一个 block 的其余线程会通过边界检查跳过数组访问。完整代码中采用等价的 n / threads + (n % threads != 0),避免计算 n + threads - 1 时产生整数加法溢出。
3.4 线程内部的数据流
从线程视角,可以把加法拆开理解:
float x = a[i];   // 读取第一个操作数
float y = b[i];   // 读取第二个操作数
float z = x + y;  // 执行加法
c[i] = z;        // 写回结果
下面是帮助理解的简化数据流,不代表每条实际机器指令的精确执行过程:
GPU 存储系统中的 a[i]、b[i]
            │ 读取,可能命中缓存
            ▼
    SM 内寄存器中的操作数
            │
            ▼
       浮点执行单元做加法
            │
            ▼
      寄存器中的计算结果
            │ 写入存储系统
            ▼
          c[i]
这个 kernel 没有线程间的数据交换,因此不需要使用 shared memory,也不需要在 kernel 内添加线程同步。
四、完整 CUDA 程序
4.1 CPU 与 GPU 之间的数据流
Kernel 只描述 GPU 上的计算。要得到一个可以运行的程序,还需要把输入送到 GPU,并把结果取回来。
CPU 内存:准备 h_a、h_b
            │ Host → Device 拷贝
            ▼
GPU 显存:d_a、d_b
            │ 启动 vector_add
            ▼
GPU 显存:结果 d_c
            │ Device → Host 拷贝
            ▼
CPU 内存:h_c,与 CPU reference 比较
变量名前缀 h_ 和 d_ 是本文的命名约定,分别表示 host 和 device。d_a 这个指针变量出现在 CPU 代码里,但它保存的地址指向 GPU 分配的存储区;CPU 把地址传给 kernel,再由 GPU 线程访问数据。
4.2 完整可运行示例
上一章的 vector_add 只定义了 GPU 线程的计算过程。要运行它,还需要 CPU 代码准备输入、分配显存、搬运数据、提交计算并读取结果。下面把这些步骤放进同一个程序,并在取回结果后与 CPU 计算的答案比较。
为方便后面修改输入长度和增加测试,程序按职责拆成几个函数:
| 函数 | 执行位置 | 在程序中的职责 |
|---|---|---|
check() | CPU | 检查 CUDA API 返回的错误状态,出错时打印原因并退出 |
vector_add() | GPU | 计算每个有效下标对应的加法,沿用上一章的 kernel |
launch_vector_add() | CPU | 处理空输入、计算启动配置并提交 kernel |
run_case(n) | CPU | 对一个指定长度,完成准备、计算、校验和资源释放 |
main() | CPU | 选择本次运行的长度,这里先使用 1025 |
主流程可以从 main() 开始读:它调用 run_case(1025);run_case() 准备好 GPU 数据后,调用 launch_vector_add();启动函数再提交 vector_add。run_case() 随后等待 GPU 完成,取回结果并进行校验。
CPU 端用 std::vector 保存数组,GPU 端用 cudaMalloc 分配显存。除了输入 h_a、h_b 和回传结果 h_c,这里还准备了 h_ref:它保存 CPU 按同一公式算出的参考答案,用来判断 GPU 输出是否正确。
完整示例已经包含空输入处理和逐元素校验。第五章会定位这两部分代码,解释判断依据,再扩展到多个长度和随机输入。示例接口约定 n >= 0,输入和输出存储区互不重叠。
#include <cuda_runtime.h>
#include <algorithm>
#include <cmath>
#include <cstdio>
#include <cstdlib>
#include <vector>

void check(cudaError_t err)
{
    if (err != cudaSuccess) {
        std::fprintf(stderr, "CUDA error: %s\n", cudaGetErrorString(err));
        std::exit(EXIT_FAILURE);
    }
}

__global__ void vector_add(
    const float* a, const float* b, float* c, int n)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) {
        c[i] = a[i] + b[i];
    }
}

// CPU 端启动函数:空输入不访问指针,也不启动 kernel。
void launch_vector_add(
    const float* a, const float* b, float* c, int n)
{
    if (n == 0) {
        return;
    }

    const int threads = 256;
    const int blocks = n / threads + (n % threads != 0);
    vector_add<<<blocks, threads>>>(a, b, c, n);
    check(cudaGetLastError());
}

bool run_case(int n)
{
    if (n < 0) {
        std::fprintf(stderr, "n must be nonnegative\n");
        return false;
    }
    if (n == 0) {
        launch_vector_add(nullptr, nullptr, nullptr, 0);
        std::printf("n=0: PASS (empty input)\n");
        return true;
    }

    // 1. 准备 CPU 输入及参考结果。
    std::vector<float> h_a(n), h_b(n), h_c(n), h_ref(n);
    for (int i = 0; i < n; ++i) {
        h_a[i] = static_cast<float>(i);
        h_b[i] = 2.0f * static_cast<float>(i);
        h_ref[i] = h_a[i] + h_b[i];
    }
    const size_t bytes = static_cast<size_t>(n) * sizeof(float);

    // 2. 分配显存。
    float *d_a = nullptr, *d_b = nullptr, *d_c = nullptr;
    check(cudaMalloc(&d_a, bytes));
    check(cudaMalloc(&d_b, bytes));
    check(cudaMalloc(&d_c, bytes));

    // 3. 输入拷到 GPU。
    check(cudaMemcpy(d_a, h_a.data(), bytes, cudaMemcpyHostToDevice));
    check(cudaMemcpy(d_b, h_b.data(), bytes, cudaMemcpyHostToDevice));

    // 4. 启动计算,并等待执行完成。
    launch_vector_add(d_a, d_b, d_c, n);
    check(cudaDeviceSynchronize());

    // 5. 取回结果,逐元素验证。
    check(cudaMemcpy(h_c.data(), d_c, bytes, cudaMemcpyDeviceToHost));
    bool passed = true;
    for (int i = 0; i < n; ++i) {
        const float tolerance = 1e-6f + 1e-5f * std::fabs(h_ref[i]);
        if (!std::isfinite(h_c[i]) ||
            std::fabs(h_c[i] - h_ref[i]) > tolerance) {
            std::fprintf(stderr,
                         "Mismatch at %d: got %.9g, expected %.9g\n",
                         i, h_c[i], h_ref[i]);
            passed = false;
            break;
        }
    }

    // 6. 释放显存。
    check(cudaFree(d_a));
    check(cudaFree(d_b));
    check(cudaFree(d_c));

    std::printf("n=%d: %s\n", n, passed ? "PASS" : "FAIL");
    return passed;
}

int main()
{
    return run_case(1025) ? EXIT_SUCCESS : EXIT_FAILURE;
}
在在线编辑器中,可以直接粘贴整个程序运行。预期输出为:
n=1025: PASS如果使用已经安装 CUDA Toolkit、连接 NVIDIA GPU 的 Linux 环境,可以将它保存为 vector_add.cu,使用以下命令编译:
nvcc -std=c++17 -O3 -arch=native vector_add.cu -o vector_add再执行:
./vector_add-arch=native 让支持这一选项的 nvcc 为当前可见的 GPU 生成代码;具体编译环境和目标架构应与所用 CUDA Toolkit 匹配,参见 NVCC 的 GPU Architecture 选项。
4.3 Kernel 的异步启动与同步
下面这一行相对于 CPU 是异步的:
vector_add<<<blocks, threads>>>(a, b, c, n);CPU 提交 kernel 后可以继续执行后续代码,返回时 GPU 可能仍在计算,甚至尚未开始执行。这也是完整程序中要检查和等待的原因。
check(cudaGetLastError());
check(cudaDeviceSynchronize());
第一行读取并清除当前 host 线程记录的 CUDA 错误状态,用于发现启动阶段的即时错误;它也可能报告先前异步工作留下的错误。返回成功不能证明当前 kernel 已经执行完成。
第二行让调用它的 CPU 线程等待当前设备上此前提交的工作完成,并检查返回状态,以便发现执行阶段的错误。
本例随后的 Device → Host cudaMemcpy 也会等待这次回传完成。显式保留 cudaDeviceSynchronize(),是为了让计算完成与结果回传的边界更清楚,不能由此推断所有方向、所有形式的内存拷贝都有相同的阻塞行为。相关细节见 CUDA Runtime API 的同步行为说明。
五、结果验证与边界处理
上一章运行 run_case(1025) 后,如果输出 PASS,说明在这组输入上,GPU 返回的每个元素都通过了与 CPU 参考结果的比较。接下来还需要检查其他情况:长度变成 1 时是否正确,刚好跨过 warp 或 block 边界时是否遗漏元素,没有数据时是否仍然能正常返回。
这一章继续使用第四章的同一份程序。先读清 run_case() 中已有的校验,再通过修改 main() 扩展输入长度,随后解释启动函数中的空输入分支,最后替换输入生成代码,补充随机测试。这样,每次改动都有明确的目的,也能与已有代码对应起来。
5.1 基于 CPU reference 的逐元素校验
CUDA API 没有报错,只能说明相关操作未报告执行错误;输出数值是否符合公式,还需要单独检查。只打印前几个结果,可能看不出尾部没有计算、某段索引遗漏等问题,因此示例检查全部输出。
先找到第四章 run_case() 的第 1 步。在初始化输入的循环里,已经有这一行:
h_ref[i] = h_a[i] + h_b[i];它在 CPU 上计算参考结果。例如,i = 2 时,示例输入为 h_a[2] = 2、h_b[2] = 4,因此 h_ref[2] = 6。GPU 完成并回传结果后,h_c[2] 就应当与这个参考值一致。
接着看第 5 步:cudaMemcpy 将 GPU 结果拷回 h_c 后,紧跟着的是下面这段已有的校验代码。这里重新列出,便于对照,不需要再添加一次。
bool passed = true;
for (int i = 0; i < n; ++i) {
    const float tolerance = 1e-6f + 1e-5f * std::fabs(h_ref[i]);
    if (!std::isfinite(h_c[i]) ||
        std::fabs(h_c[i] - h_ref[i]) > tolerance) {
        std::fprintf(stderr,
                     "Mismatch at %d: got %.9g, expected %.9g\n",
                     i, h_c[i], h_ref[i]);
        passed = false;
        break;
    }
}
passed 初始为真。循环逐个检查 h_c[i];一旦遇到不符合要求的结果,就打印下标、实际值和参考值,将 passed 设为假。它最后决定这个用例打印 PASS 还是 FAIL,并通过返回值把结果交给 main()。
对于当前例子,在 n = 1025 时,输入和结果都是 FP32 可以精确表示的小整数,直接比较也可以成立。代码使用绝对误差与相对误差相结合的方式,方便后面换成普通浮点输入:
允许误差 = atol + rtol × |reference|其中绝对误差项照顾接近零的结果,相对误差项随结果幅值变化。示例的 atol = 1e-6、rtol = 1e-5 是当前有限 FP32 输入下的演示选择;其他算子需要根据数据类型、算法和数值范围单独确定。由于当前参考结果有限,代码还显式拒绝非有限输出,避免 NaN 在普通大小比较中被漏过。
5.2 边界尺寸测试
明确单个用例怎样判定通过后,就可以用相同流程检查不同长度。当前每个 block 有 256 个线程,每个 warp 有 32 个线程,因此先围绕这些分组边界选取长度,再补充最小输入和较大输入:
n | 检查目的 |
|---|---|
| 0 | 没有数据时,是否正确返回 |
| 1 | 只有一个有效元素 |
| 31、32、33 | warp 边界附近 |
| 255、256、257 | 当前 block size 的边界附近 |
| 1025 | 多个 block,最后剩一个元素 |
| 1,000,003 | 较大且不能整齐划分的输入 |
第四章的 main() 只调用了一次 run_case(1025)。现在希望依次执行表中的每个长度,因此保留 check()、kernel、启动函数和 run_case(),只将原来的 main() 替换为下面的循环:
int main()
{
    const int lengths[] = {0, 1, 31, 32, 33, 255, 256, 257, 1025, 1000003};
    for (int n : lengths) {
        if (!run_case(n)) {
            return EXIT_FAILURE;
        }
    }
    return EXIT_SUCCESS;
}对于每个非空长度,run_case(n) 都会准备输入、执行计算并检查全部输出;空输入则走下一节解释的提前返回分支。出现一个失败用例,main() 就以失败状态结束。如果所有用例都通过,预期会依次看到 n=0、n=1 等长度对应的 PASS。
CPU 数组使用动态分配的 std::vector,可以避免直接把大数组放进函数的栈空间。若在线环境对运行时间或输入规模有限制,可以先执行前面的小尺寸,将大输入测试留到可用资源充足的环境。
逐元素校验检查的是输出结果;即使全部通过,也不能据此证明所有内存访问都安全。后续学习内存检查工具时,再补充这部分验证。
5.3 空输入的处理约定
上面的测试列表包含 n = 0。它与其他长度不同:没有任何元素需要计算,也就没有数组内容需要搬运。本文为它规定的行为是:启动函数直接返回,不访问输入输出指针,也不启动 kernel。
这个行为已经写在第四章的 launch_vector_add() 中。下面把函数连同判断位置一起列出,重点看 return 位于启动配置和 kernel 提交之前;不需要在文件中再定义一遍这个函数。
void launch_vector_add(
    const float* a, const float* b, float* c, int n)
{
    if (n == 0) {
        return;
    }

    const int threads = 256;
    const int blocks = n / threads + (n % threads != 0);
    vector_add<<<blocks, threads>>>(a, b, c, n);
    check(cudaGetLastError());
}
判断放在 CPU 端,是因为仅在 kernel 内检查 i < n,无法阻止 CPU 提交一个不必要或不合法的启动配置。使用向上取整公式时,n = 0 会得到 blocks = 0,因此应在计算和使用配置前处理空输入。
与它对应,run_case() 在创建数组和分配显存之前,也有一个 n == 0 分支:它用空指针调用 launch_vector_add(nullptr, nullptr, nullptr, 0),正常返回后打印 PASS 并结束用例。因此,run_case(0) 本身不执行 GPU 计算。
5.4 固定种子的随机输入测试
前面的长度测试改变了数组有多长,但输入内容仍是 a[i] = i、b[i] = 2i。这组数据便于手算;接下来保持计算和校验流程,改用随机输入,补充正负数和不同数值组合。为了让同一次失败能够重现,需要固定随机种子。
这一步需要修改原程序的两处位置。先在文件顶部已有的头文件列表中添加:
#include <random>然后找到 run_case() 第 1 步,在 std::vector<float> h_a(n), h_b(n), h_c(n), h_ref(n); 之后,将原来的输入初始化循环替换为下面代码。数组声明、后续显存操作以及第 5 步的校验都继续使用原有实现:
std::mt19937 rng(2026);
std::uniform_real_distribution<float> dist(-1.0f, 1.0f);

for (int i = 0; i < n; ++i) {
    h_a[i] = dist(rng);
    h_b[i] = dist(rng);
    h_ref[i] = h_a[i] + h_b[i];
}
rng 使用固定种子 2026,dist 将生成的数据限制在 -1 到 1 的范围内。每次填入新的 h_a[i]、h_b[i] 时,也同时重新计算对应的 h_ref[i],保证 GPU 结果与这一组输入的 CPU 答案比较。
完成替换后,再运行 5.2 节的长度列表,就能用同一套测试流程覆盖随机输入。在固定代码和相同运行环境下,重复执行会得到相同的输入序列。不同标准库对分布转换的实现可能不同;跨环境严格复现时,应保存测试数据或固定数据生成实现。
六、CUDA 程序计时
6.1 计时范围与成本划分
从 CPU 输入到 CPU 结果,一次工作可能包含:
分配显存 → 输入传输 → kernel 执行 → 结果回传 → 验证与打印不同起止位置回答不同问题。记录耗时时,至少写清下面两类范围:
| 测量目标 | 本文采用的范围 |
|---|---|
| GPU 计算区间 | 输入和输出缓冲区已准备好,测量两个 CUDA event 之间的一批 kernel |
| 一次完整数据往返调用 | 从输入传输开始,到结果回传完成;显存已预分配 |
如果还希望包含显存分配与释放,就把计时起止点放到它们外侧,并在报告中注明。编译、预热、正确性检查、打印也应分别说明是否包含,不能笼统地都叫“kernel 时间”。
6.2 CPU 计时与异步提交
下面这种写法只能反映 CPU 发起这次调用的耗时,不能证明 GPU 已完成计算:
CPU 开始计时
    提交 kernel
CPU 结束计时
    GPU 可能仍在执行
如果使用 CPU 时钟测量提交到完成的耗时,需要先排除此前未完成的工作,在计时结束前等待目标 GPU 工作完成。这样得到的时间包含 CPU 提交、等待以及所包围工作的成本。
6.3 CUDA events 计时
CUDA event 可以放进 GPU 的 stream(有序工作队列)中。GPU 执行到 event 对应的位置时记录时间,之后可以计算两个标记的时间差。本文所有拷贝、kernel 和 event 都使用同一个默认 stream,不展开多 stream 场景。
同一个默认 stream 内的顺序:
start event → kernel 0 → kernel 1 → …… → kernel 999 → stop event
CPU 调用 cudaEventRecord(stop) 时,只是把 stop 标记提交到队列,并不代表 GPU 已经到达那里。因此,要先等待 stop 完成,再读取时间:
check(cudaEventSynchronize(stop));
check(cudaEventElapsedTime(&total_ms, start, stop));
cudaEventElapsedTime 的返回单位是毫秒。具体用法可对照 NVIDIA 官方 GPU 计时示例。
6.4 预热、重复测量与波动
首次执行可能受到初始化、代码加载等一次性工作的影响。计时前先完成相关准备并运行若干次,让测量更接近重复调用的状态,这一步称为 warmup。预热不保证频率和系统负载完全稳定,所以仍需要观察多组结果。
对于很短的 kernel,单次测量还容易受到计时分辨率和标记开销的影响。可以连续提交多次,再用总时间除以次数。这里测 5 组,每组 1000 次,报告每组平均值的中位数和范围。
将下面函数放在 launch_vector_add() 之后、run_case() 之前:
void benchmark_vector_add(
    const float* d_a, const float* d_b, float* d_c, int n)
{
    if (n == 0) {
        std::printf("Timing skipped: empty input\n");
        return;
    }

    int device;
    cudaDeviceProp prop;
    check(cudaGetDevice(&device));
    check(cudaGetDeviceProperties(&prop, device));

    const int threads = 256;
    const int blocks = n / threads + (n % threads != 0);
    const int repeats = 1000;
    std::printf("Device: %s, n=%d, blocks=%d, threads=%d\n",
                prop.name, n, blocks, threads);

    cudaEvent_t start, stop;
    check(cudaEventCreate(&start));
    check(cudaEventCreate(&stop));

    // 预热,排除在测量区间外。
    for (int k = 0; k < 50; ++k) {
        vector_add<<<blocks, threads>>>(d_a, d_b, d_c, n);
    }
    check(cudaGetLastError());
    check(cudaDeviceSynchronize());

    std::vector<float> samples;
    for (int trial = 0; trial < 5; ++trial) {
        check(cudaEventRecord(start));
        for (int k = 0; k < repeats; ++k) {
            vector_add<<<blocks, threads>>>(d_a, d_b, d_c, n);
        }
        check(cudaGetLastError());
        check(cudaEventRecord(stop));
        check(cudaEventSynchronize(stop));

        float total_ms;
        check(cudaEventElapsedTime(&total_ms, start, stop));
        const float average_us = total_ms * 1000.0f / repeats;
        samples.push_back(average_us);
        std::printf("Trial %d: %.3f us/launch\n", trial + 1, average_us);
    }

    std::sort(samples.begin(), samples.end());
    std::printf("Median of batch averages: %.3f us/launch\n", samples[2]);
    std::printf("Range: %.3f - %.3f us/launch\n",
                samples.front(), samples.back());

    check(cudaEventDestroy(start));
    check(cudaEventDestroy(stop));
}
然后在 run_case() 中完成结果校验之后、释放显存之前添加:
if (passed) {
    benchmark_vector_add(d_a, d_b, d_c, n);
}
做计时实验时,先使用只调用 run_case(1025) 的 main(),将边界测试与性能测量分开运行。输入已经位于 GPU,测量区间内没有显存分配、数据传输或打印;这些操作的耗时没有被包含进去。
这里还要区分两个统计量:代码报告的是 5 个批次平均耗时的中位数,不是逐次测得 5000 个 kernel 延迟后的中位数。
这段结果更准确的表述是:当前提交方式下,指定 GPU 时间区间内每次调用的平均耗时。 对很短的 kernel,如果 CPU 来不及持续提交任务,event 区间内可能包含 GPU 等待后续任务的空档,不能把结果直接当作单个 kernel 内部指令执行的精确时间。
代码反复使用同一组数组,缓存条件也会随重复访问变化。因此,后续即使用必要字节数除以时间估算带宽,也要说明缓存条件,不能直接把它当成显存芯片的实测带宽。
6.5 包含数据传输的完整调用计时
如果关心的是“CPU 已有输入,多久能拿到 CPU 结果”,可以使用 CPU 时钟包住输入传输、kernel 和结果回传。
在头文件中添加 #include <chrono>。在 run_case() 中,将第 3~5 步从输入拷贝到结果回传的那一段,替换为下面代码,后面的逐元素检查保持不变:
// 此时显存已经分配,h_a、h_b 也已经初始化。
check(cudaDeviceSynchronize());
const auto begin = std::chrono::steady_clock::now();

check(cudaMemcpy(d_a, h_a.data(), bytes, cudaMemcpyHostToDevice));
check(cudaMemcpy(d_b, h_b.data(), bytes, cudaMemcpyHostToDevice));
launch_vector_add(d_a, d_b, d_c, n);
check(cudaDeviceSynchronize());
check(cudaMemcpy(h_c.data(), d_c, bytes, cudaMemcpyDeviceToHost));

const auto end = std::chrono::steady_clock::now();
const double elapsed_us =
    std::chrono::duration<double, std::micro>(end - begin).count();
std::printf("H2D + launch + wait + D2H: %.3f us\n", elapsed_us);
这段时间包含两次输入传输、CPU 提交 kernel、等待以及结果回传,显存分配、CPU 输入初始化和结果验证位于区间外。这里展示一次测量的边界,做稳定对比时,同样需要先预热、多次重复,并报告波动。
它与 CUDA events 示例回答的是两个问题:前者关心 CPU 侧一次数据往返何时完成,后者关心数据已准备好时的一段 GPU 工作区间。两者的计时边界不同,不应将结果混用。
总结
本文从 GPU 硬件结构出发,认识了 SM、计算单元和存储层次,再将 CUDA 中的 grid、block、warp、thread 与硬件执行联系起来。线程通过 block 编号和块内编号计算数组下标,从而确定自己负责的数据。
以向量加法为例,我们完成了从 CPU 准备输入、分配 GPU 显存、搬运数据、启动 kernel,到取回结果和释放资源的完整流程。Kernel 启动相对于 CPU 是异步的,因此需要区分任务提交与计算完成,并通过错误检查和同步确认执行状态。
在运行程序之后,我们进一步用 CPU reference 检查全部输出,补充边界尺寸、空输入和固定种子的随机测试。计时则分别考察数据已准备好时的 GPU 工作区间,以及包含输入输出传输的一次完整调用,并通过预热、重复测量和波动记录明确结果的含义。
这些步骤构成了后续 CUDA 实验的基本流程:明确线程分工,完成数据搬运,验证计算结果,再在清楚的计时范围内比较性能。后续学习访存与更复杂的算子时,可以继续沿用这套方法。